
Ubah format dokumen
OCR PDF hasil scan
OCR PDF menambahkan lapisan teks yang bisa dicari pada hasil scan dalam lebih dari 100 bahasa.
Pilih file
Pilih satu PDF hasil scan dengan maksimal 80 halaman dan 120 MB.
Cari dan salin tulisan dari PDF hasil scan
OCR membaca tulisan pada gambar dan menambahkan lapisan teks. Gambar halaman tetap terlihat; kata yang dikenali bisa dicari, dipilih, dan disalin.
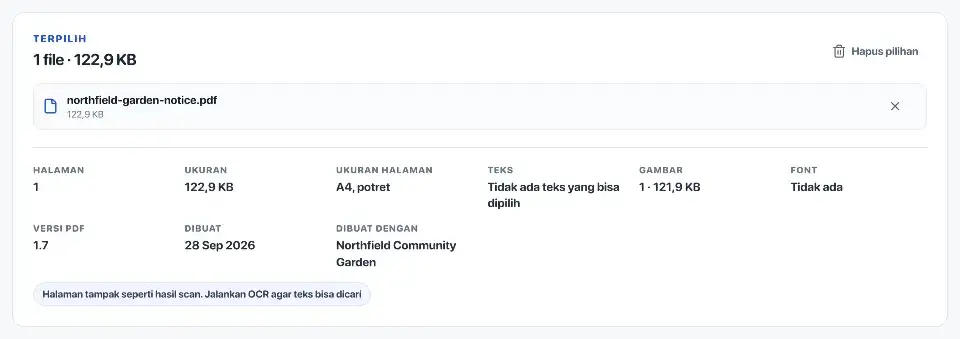
Pastikan halaman memang membutuhkan OCR
Coba cari satu kata yang terlihat, lalu salin satu kalimat. PDF digital mungkin sudah memiliki teks. PDF hasil scan juga bisa memiliki lapisan OCR meskipun halaman yang terlihat masih berupa gambar.
Rebuildfree memeriksa teks yang sudah ada dan menambahkan baris yang belum tersedia. Jika tidak ada teks baru yang diperlukan, alat memberi tahu bahwa PDF sudah bisa dicari. OCR ini tidak mengubah tulisan pada gambar menjadi teks yang bisa diedit langsung.
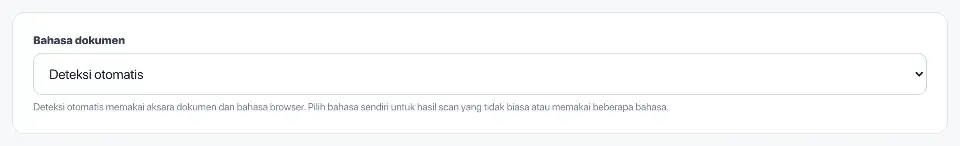
Pilih bahasa tulisan pada dokumen
Pilih satu PDF hingga 80 halaman dan 120 MB. Gunakan deteksi otomatis atau tentukan bahasanya. Tersedia lebih dari 100 bahasa pengenalan. Paket bahasa diunduh sebelum OCR berjalan di perangkat; dokumen tidak ikut dikirim.
Untuk dokumen lebih panjang, gunakan Ambil halaman PDF untuk membuat beberapa bagian. Beri nama yang jelas agar urutannya tidak tertukar. PDF bertanda tangan digital tidak diberi OCR karena perubahan file akan membatalkan tanda tangan tersebut.
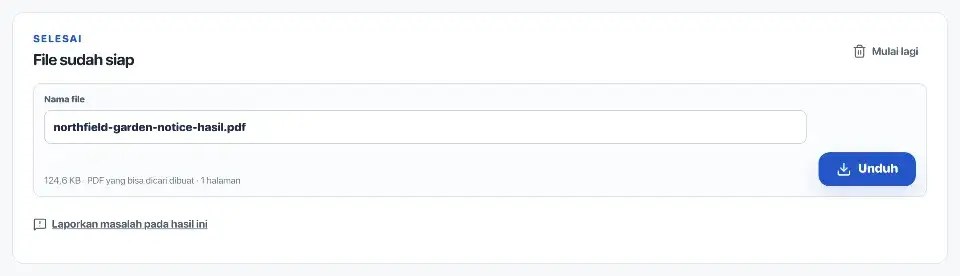
Cocokkan hasil bacaan dengan gambar
Buka hasil di pembaca PDF lain. Cari nama, tanggal, atau nomor referensi yang terlihat pada halaman. Salin satu paragraf dan periksa urutan kata, terutama pada tabel dan dokumen berkolom.
Pemeriksaan jumlah halaman, tampilan, dan lapisan teks tidak menjamin setiap kata terbaca benar. Cetakan pudar, silau, tulisan tangan, dan tata letak rumit masih bisa menghasilkan kesalahan. Simpan scan sumber untuk membandingkannya.
Pertanyaan umum
Apa itu OCR dan kapan saya membutuhkannya?
OCR membaca tulisan pada halaman hasil scan (pindai) dan menambahkan lapisan teks tak terlihat, sehingga PDF hasil scan bisa dicari dan disalin. Gunakan OCR jika teks di PDF tidak bisa dipilih atau ditemukan.
Bahasa apa saja yang didukung?
Tersedia lebih dari 100 bahasa pengenalan Tesseract, termasuk bahasa Indonesia, Inggris, Arab, Tionghoa, Jepang, dan Korea.
Apakah tampilan PDF akan berubah?
OCR menambahkan lapisan teks tak terlihat di belakang gambar halaman. Gambar halaman tetap menjadi tampilan PDF.
Apakah halaman dokumen ikut diunggah saat OCR?
Tidak ada halaman dokumen yang dikirim ke server. Paket pengenalan teks yang dipilih diunduh dan disimpan di perangkat, lalu OCR berjalan di browser ini.