
Membuat tulisan hasil scan bisa dicari
Tambahkan lapisan teks OCR agar kata pada scan bisa ditemukan dan disalin. Gambar halaman tetap menjadi rujukan untuk memeriksa hasil bacaan.
Uji pencarian sebelum menjalankan OCR
Cari satu kata yang terlihat, lalu salin satu kalimat. Jika hasilnya sesuai, halaman mungkin sudah memiliki lapisan teks.
Coba halaman awal, tengah, dan akhir serta bagian dengan tabel atau font berbeda. OCR lama dapat membaca judul tetapi melewatkan isi atau menempatkan teks secara keliru.
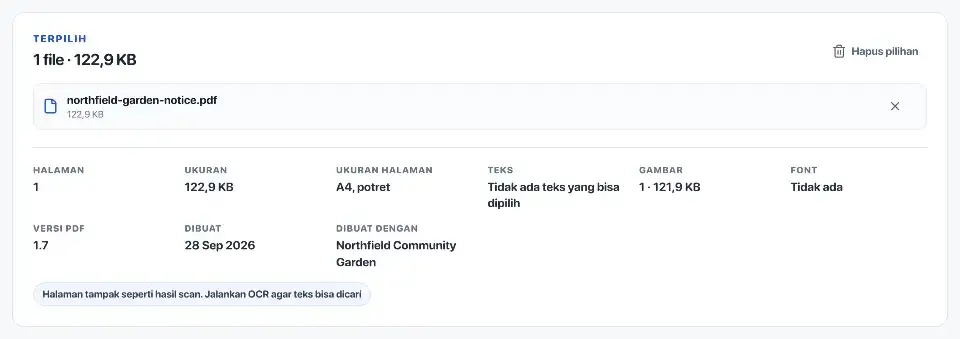
Pahami apa yang ditambahkan OCR
OCR membaca piksel dan menambahkan teks di belakang gambar. Tampilan halaman bisa tetap benar meskipun kata yang disalin salah.
PDF yang bisa dicari belum tentu bisa diedit atau sudah aksesibel. Urutan baca, struktur judul, tabel, bahasa dokumen, dan keterangan gambar memerlukan pemeriksaan tersendiri.
Gunakan halaman yang jelas dan tegak
Perbaiki arah dan perspektif terlebih dahulu. Jika tulisan kabur atau silau, ambil ulang scan; peningkatan kontras berlebihan dapat menghilangkan tanda baca.
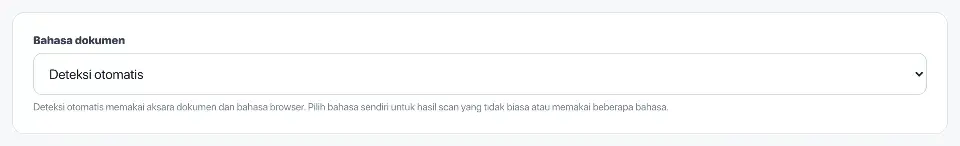
Pilih bahasa yang tercetak atau gunakan deteksi otomatis. OCR Rebuildfree menerima hingga 80 halaman dan 120 MB. Untuk sumber lebih panjang, buat beberapa bagian dengan Ambil halaman PDF.
Cocokkan kata penting dengan gambar
Cari nama, tanggal, nominal, dan nomor referensi. Salin paragraf serta beberapa sel tabel dan periksa urutannya. Pada dokumen berkolom, pastikan bacaan tidak melompat antar-kolom.
Tidak ada jaminan semua karakter dikenali benar. Jika teks akan dimasukkan ke sistem lain, periksa lagi setelah salin-tempel; proses ekstraksi dapat mengubah urutan baris.
- Nama, tanggal, nominal, dan nomor referensi sesuai dengan halaman.
- Kata di ujung baris tidak rusak saat disalin.
- Kolom dibaca dalam urutan yang benar.
- Sensor permanen juga menghapus teks tersembunyi.
- PDF dapat dicari di aplikasi pembaca lain.
Jaga keterbacaan saat memperkecil file
Gambar halaman biasanya lebih menentukan ukuran daripada lapisan OCR. Kompres secukupnya dan perbesar huruf terkecil pada hasil.
Kompresi seluruh halaman dapat menghilangkan teks yang bisa dicari, tautan, dan formulir interaktif. Simpan scan sumber dan uji pencarian lagi setelah kompresi.
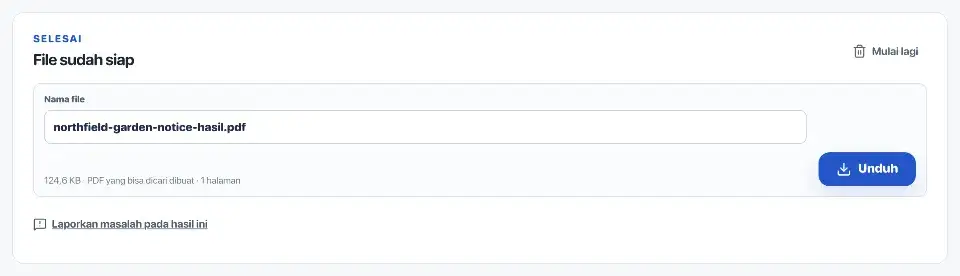
Beri nama jelas pada versi OCR
Simpan sumber dan hasil secara terpisah. Buka hasil di pembaca PDF lain untuk menguji pencarian, pemilihan, dan penyalinan tulisan.
OCR berlangsung di browser dan tidak ditambahkan ke PDF bertanda tangan digital. Paket bahasa diunduh jika diperlukan; dokumen tidak ikut dikirim. Catat versi yang sudah diperiksa jika dipakai sebagai arsip.
Sumber rujukan
Rujukan ini diperiksa pada 14 Agustus 2026 untuk keterangan teknis atau langkah yang dibahas.