
Dokumente umwandeln
PDF durchsuchbar machen (OCR)
Ergänzen Sie Scans um eine unsichtbare Textebene zum Suchen und Kopieren. Über 100 Erkennungssprachen stehen bereit.
Datei auswählen
Wählen Sie ein gescanntes PDF mit höchstens 80 Seiten und 120 MB.
Text in gescannten PDFs finden und kopieren
Texterkennung (OCR) ergänzt den Scan um eine unsichtbare Textebene. Das Seitenbild bleibt sichtbar; die erkannten Wörter lassen sich suchen, markieren und kopieren.
Was sich am Scan ändert
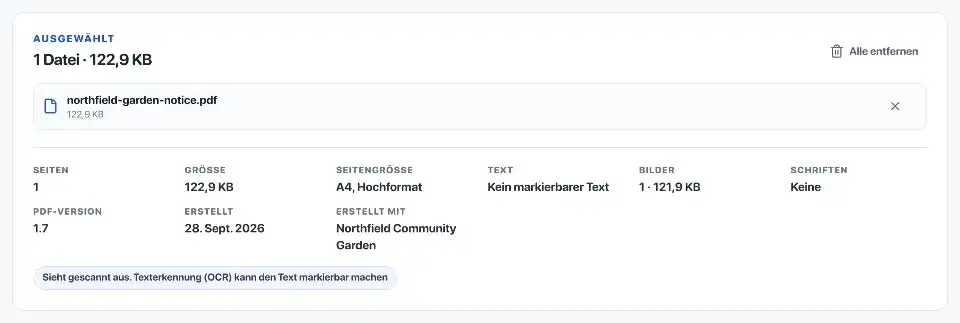
Ein Scan enthält meist ein Bild der Seite. OCR legt den erkannten Text dahinter. Sie macht daraus weder bearbeitbare Word-Absätze noch korrigiert sie den aufgedruckten Wortlaut.
Zur Erkennung kann eine aufgehellte Kopie des Bildes dienen. Diese ersetzt das sichtbare Original im Ergebnis nicht.
Sprache auswählen und Erkennung starten
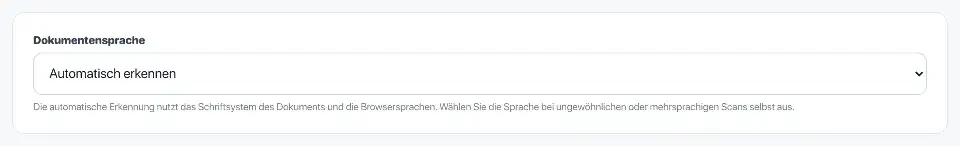
Lassen Sie die Sprache automatisch bestimmen oder wählen Sie die gedruckte Sprache selbst. Über 100 Erkennungssprachen stehen bereit, darunter Arabisch und Hebräisch. Benötigte Sprachdateien werden vor der Verarbeitung auf das Gerät geladen.
Vorhandener Text wird berücksichtigt. Das Tool ergänzt fehlende erkannte Zeilen. Ist nichts zu ergänzen, meldet es, dass das PDF bereits durchsuchbar ist.
Einige Fundstellen mit dem Bild abgleichen
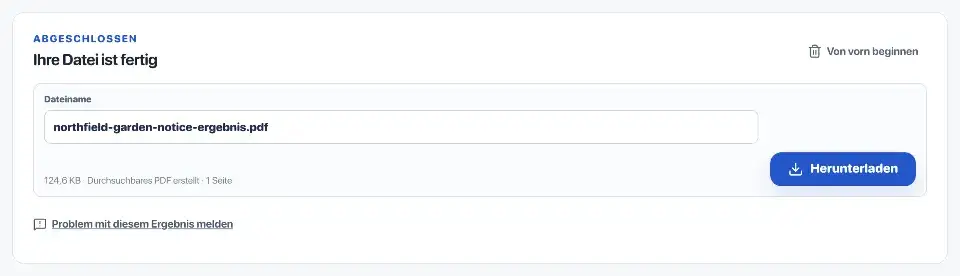
Vor dem Download werden Seitenzahl, Maße, Drehung, Textebene und Seitenansicht geprüft. Diese Kontrolle bestätigt nicht, dass jedes Wort richtig erkannt wurde.
Suchen Sie im gespeicherten PDF nach einem sichtbaren Namen oder einer Nummer. Kopieren Sie einen Satz und vergleichen Sie ihn mit dem Scan. Blasser Druck, Spiegelungen und Handschrift können Fehler verursachen.
Längere oder signierte PDFs vorbereiten
Ein Vorgang nimmt höchstens 80 Seiten und 120 MB an. Extrahieren Sie aus längeren PDFs passende Seitenpakete und benennen Sie diese eindeutig.
Digital signierte PDFs werden nicht um OCR ergänzt, weil die Änderung die Signatur ungültig machen würde. Bewahren Sie die signierte Quelle auf.
Häufige Fragen
Was ist OCR und wann brauche ich es?
OCR liest die Schrift auf einer gescannten Seite und legt eine unsichtbare Textebene hinter das Seitenbild, damit sich das PDF durchsuchen und kopieren lässt. Sie brauchen OCR, wenn sich Text in einem PDF nicht markieren oder finden lässt.
Welche Sprachen erkennt die PDF-Texterkennung?
Verfügbar sind mehr als 100 Sprachmodelle aus dem aktuellen Tesseract-Verzeichnis, darunter Türkisch, Arabisch, indische Schriften, Chinesisch, Japanisch, Koreanisch und historische Varianten.
Verändert die OCR das Aussehen meines PDFs?
Nein. OCR ergänzt unsichtbaren, durchsuchbaren Text hinter dem sichtbaren Seitenbild und verändert dessen Aussehen nicht.
Werden meine Seiten für die OCR hochgeladen?
Nein, keine Seite Ihres Dokuments wird hochgeladen. Heruntergeladen und zwischengespeichert wird nur das ausgewählte Erkennungspaket; danach läuft die OCR in diesem Browser.